 Analysegespräch buchen
Das Wichtigste in Kürze
- KI-Spracherkennung erreicht 2026 im ruhigen Büroalltag eine sehr hohe Genauigkeit in Deutsch (Whisper Large v3: rund 4 Prozent Wort-Fehlerrate unter Studiobedingungen), in lauten Umgebungen gleichen gute Mikrofone viel aus.
- Lokale Spracherkennung mit Whisper von OpenAI läuft vollständig offline auf eigener Hardware, in 99 Sprachen, ohne dass Audiodaten das Unternehmen verlassen.
- Cloud-Spracherkennung (Azure, Google, OpenAI) kostet ab 0,006 Dollar pro Minute Audio und ist schnell aufgesetzt, aber bei sensiblen Daten DSGVO-rechtlich heikel.
- Konkrete Anwendungsfälle im Mittelstand: Servicetechniker-Doku (30 bis 60 Minuten Zeitgewinn pro Tag), Praxis-Befunde, Meeting-Mitschriften, Telefonie.
- Lokales Setup startet hardware-seitig ab 2.500 Euro, läuft danach praktisch kostenfrei.
KI-Spracherkennung erreicht mit Whisper von OpenAI 2026 in Deutsch eine Wort-Fehlerrate von rund 4 Prozent unter Studiobedingungen und lässt sich vollständig lokal betreiben (OpenAI Whisper Paper, 2022). Dein Servicetechniker spricht den Wartungsbericht ins Tablet statt ihn am Abend zu tippen. Die Arzthelferin diktiert den Befund direkt in die Patientenakte. Das Vertriebsmeeting transkribiert sich selbst und landet sauber als Protokoll im CRM.
Lokale Spracherkennung ist der Anwendungsbereich lokaler KI, der für Mittelständler mit hohem Dokumentationsaufwand den größten Unterschied macht. Was lange Zukunftsmusik war, läuft heute auf einem unauffälligen Server in deiner Firma, ohne dass Audiodaten je das Haus verlassen. Dieser Artikel erklärt dir, wie KI-Spracherkennung 2026 funktioniert, welche Anwendungsfälle im Mittelstand wirklich Wert schaffen, wann lokal Pflicht ist und wann Cloud reicht.
Inhalt
- Drei Faktoren machen KI-Spracherkennung 2026 praxisreif
- So funktioniert moderne Spracherkennung technisch
- Anwendungsfälle, die im Mittelstand wirklich Wert schaffen
- Lokal vs Cloud: Die DSGVO-Entscheidung
- Lokale Spracherkennung startet ab 2.500 Euro, Cloud ab 0,006 Dollar pro Minute
- So startest du in vier Wochen
- Mikrofon, Fachvokabular und Change Management entscheiden über den Erfolg
- Fazit
Drei Faktoren machen KI-Spracherkennung 2026 praxisreif
Wer Spracherkennung aus den Zehnerjahren kennt, hat ein veraltetes Bild. Bis etwa 2022 war Dragon NaturallySpeaking der Standard, und der war: empfindlich gegen Hintergrundgeräusche, abhängig von Sprecher-Training, kostspielig in der Lizenzierung. Mit der Veröffentlichung von Whisper durch OpenAI 2022 hat sich das fundamental geändert.
Heute geht es nicht mehr darum, ob die Spracherkennung gut ist, sondern wie du sie sinnvoll in deine Prozesse einbaust. Drei Faktoren machen den Unterschied:
- Genauigkeit. Whisper Large v3 erreicht in Deutsch unter Studiobedingungen eine Wort-Fehlerrate von rund 4 Prozent (OpenAI Whisper Paper, 2022). Im ruhigen Büroalltag erreichen moderne Systeme eine sehr hohe Erkennungsgenauigkeit, die für Diktate und Protokolle locker ausreicht.
- Robustheit gegen Lärm. Auch in einer Werkstatt mit laufendem Kompressor oder im Außendienst neben einer Straße liefert das System brauchbare Transkripte. In solchen lauten Umgebungen sinkt die Genauigkeit spürbar, gute Mikrofone gleichen viel davon aus.
- Lokaler Betrieb. Whisper lokal betrieben läuft komplett offline: Audiodaten müssen kein Unternehmensnetz verlassen.
Wort-Fehlerrate Whisper Large v3 in Deutsch (Studiobedingungen)
OpenAI Whisper Paper, 2022der Arbeitszeit verbringen Wissensarbeiter mit der Suche nach Informationen
McKinsey Global Institute, The Social Economy, 2012Sprachen werden von Whisper unterstützt, inklusive Deutsch, Schweizerdeutsch und Österreichisch
OpenAI, 2022So funktioniert moderne Spracherkennung technisch
Klassische Spracherkennung arbeitete in zwei Stufen: ein akustisches Modell ordnet Laute zu, ein Sprachmodell rekonstruiert daraus Wörter. Beide Stufen brauchten massives Tuning und brachen schnell zusammen, sobald der Sprecher hustete oder das Mikrofon weiter weg stand.
Moderne Systeme wie Whisper sind End-to-End-Modelle, trainiert auf hunderttausenden Stunden Audio aus dem Internet. Sie übersetzen direkt Audio in Text und haben dabei Akzente, Hintergrundgeräusche und sogar Codes mitgelernt. Das Ergebnis: ein einziges Modell, das ohne Anpassung in fast jedem Szenario brauchbar liefert.
Für Unternehmen bedeutet das: kein wochenlanges Sprecher-Training, kein separates Audio-Engineering. Du gibst dem System eine Audiodatei oder einen Live-Stream und bekommst Text zurück, oft inklusive Zeitstempeln und Sprecher-Trennung.
Anwendungsfälle, die im Mittelstand wirklich Wert schaffen
Spracherkennung lohnt sich überall dort, wo Menschen heute tippen, was sie eigentlich auch sprechen könnten. Vier typische Szenarien, in denen Spracherkennung im Mittelstand konkret Zeitgewinn bringt:
Servicetechniker im Außendienst (HLK, Sanitär, Industrie)
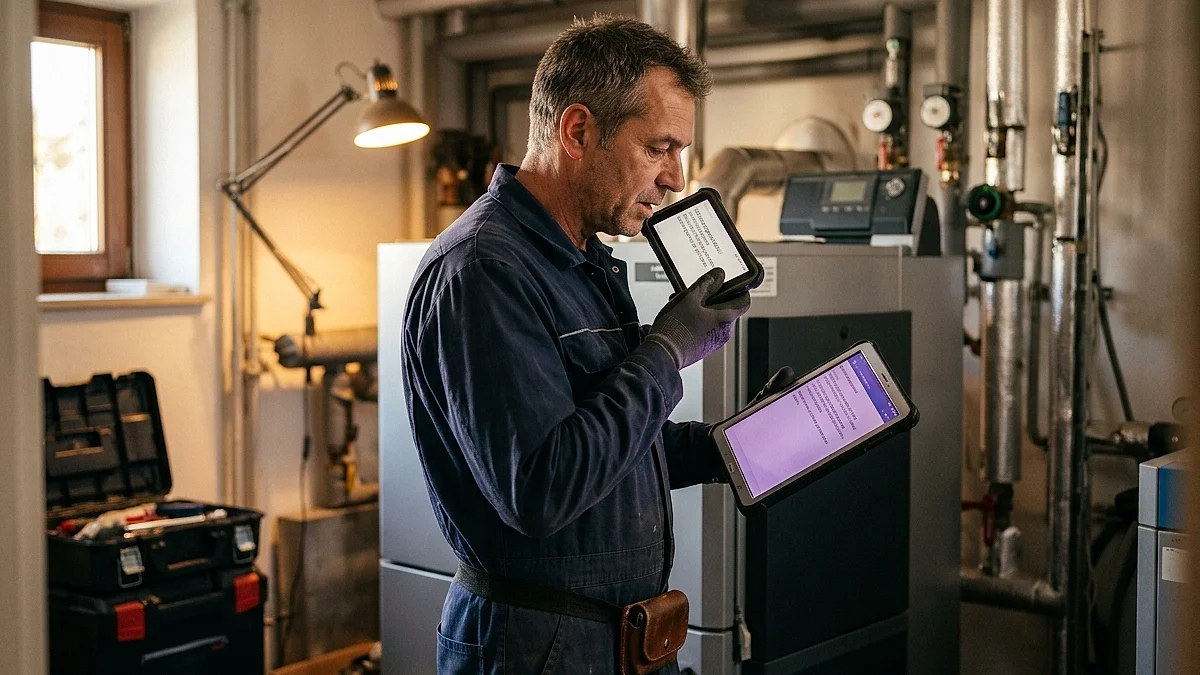
Stell dir einen HLK-Servicetechniker vor. Nach jedem Einsatz steht er vor der Wahl: vor Ort zwischen zwei Aufträgen tippen oder abends im Büro Berichte nachpflegen. Beides frisst Zeit. Mit einer Spracherkennungs-App diktiert er den Bericht direkt in eine strukturierte Vorlage. Ein KI-Modell hinter der Erkennung ergänzt Anlagen-IDs, ordnet Symptome zu Fehlerklassen zu und legt den Bericht automatisch im richtigen Auftrag ab.
Effekt: Berichte sind am gleichen Tag fertig, die Disposition kann direkt nachverkaufen, der Techniker hat 30 bis 60 Minuten pro Tag zurück.
Praxis- und Klinik-Dokumentation
In Arztpraxen und kleinen Kliniken bindet die Dokumentation erfahrungsgemäß einen erheblichen Teil der Arbeitszeit von Ärzten und MFAs. Eine lokal laufende Spracherkennung diktiert Befunde direkt in die Praxis-Software, mit medizinischem Fachvokabular und ICD-Code-Vorschlägen. Weil das Modell lokal läuft, verlässt kein Patientenname das Praxisnetz.
Meeting-Mitschriften und Vertriebsdoku
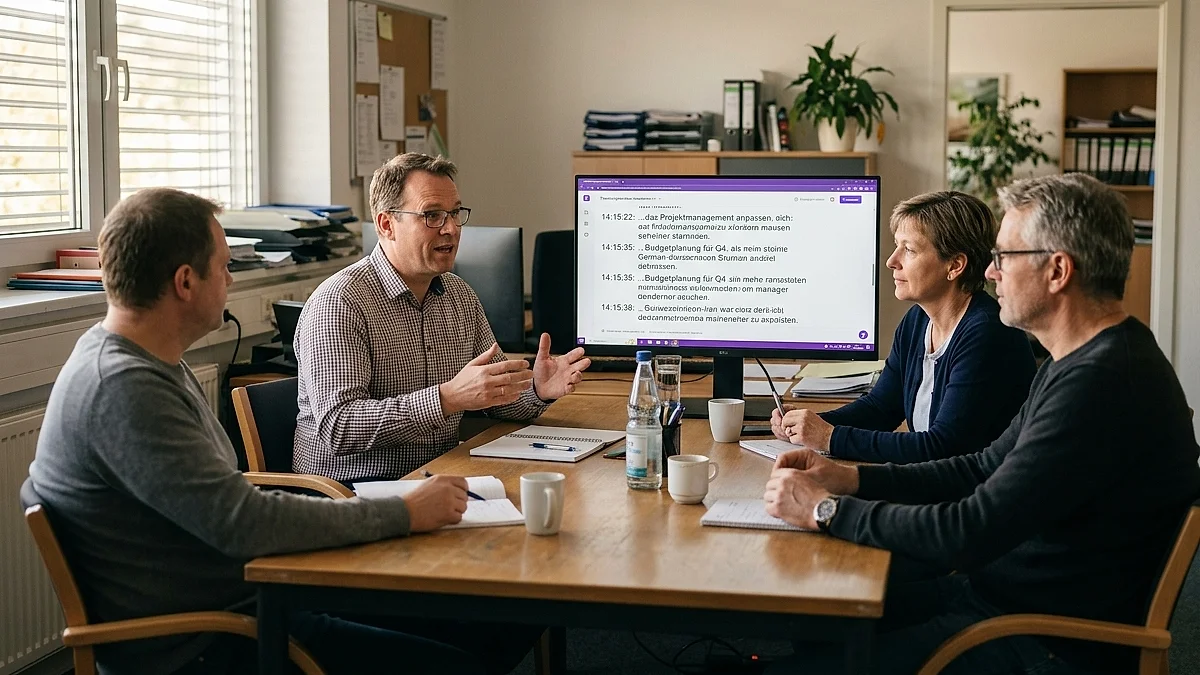
Vertriebsteams haben das gleiche Problem in der Bürowelt: Gesprächsnotizen, die im Nachgang erstellt werden, sind ungenau und kosten Zeit. Mit live mitlaufender Spracherkennung wird das Meeting transkribiert, eine KI extrahiert Action Items, Entscheidungen und nächste Schritte und legt sie strukturiert im CRM ab.
Telefonie und Kundenservice
Wer Anrufe entgegennimmt, hat den klassischen Anwendungsfall: das, was am Telefon gesagt wird, soll als Text dokumentiert sein. Hier greift Spracherkennung in Kombination mit einem KI-Telefonassistent, der Anrufe annimmt, qualifiziert und Termine bucht, ohne dass das Team am Hörer bleiben muss.
Lokal vs Cloud: Die DSGVO-Entscheidung
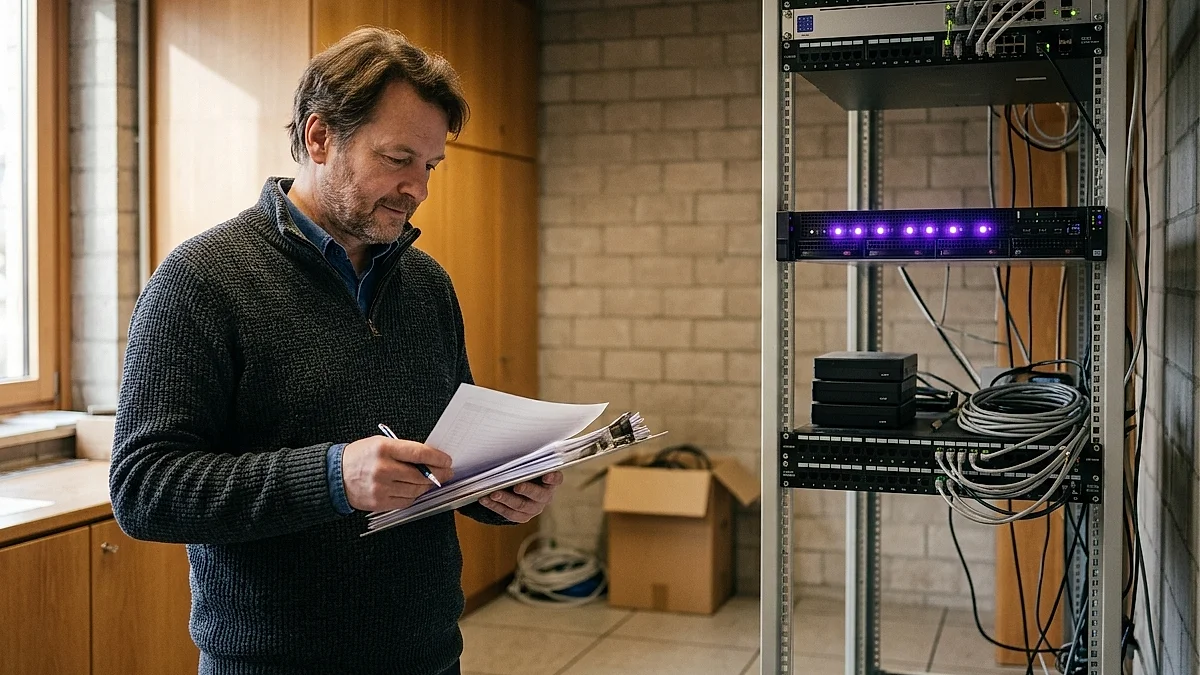
Hier kommt die zentrale Frage. Bei jedem Unternehmen, das Spracherkennung einführen will, entscheidet sich am Anfang, ob die Audiodaten in der Cloud oder on-premise, also auf eigener Hardware im Haus, verarbeitet werden. Die Entscheidung hat direkte DSGVO-Folgen.
| Kriterium | Lokale Spracherkennung | Cloud-Spracherkennung |
|---|---|---|
| Beispiel-Lösungen | Whisper self-hosted, Vosk, NVIDIA Parakeet | OpenAI Whisper API, Azure Speech, Google Speech-to-Text |
| Audiodaten verlassen das Unternehmen | Nein | Ja |
| DSGVO-Aufwand | Gering, keine Drittlandübermittlung | AVV plus Datenschutz-Folgenabschätzung notwendig |
| Einrichtungsaufwand | Mittel, Hardware und Setup | Niedrig, API-Key reicht |
| Einmalige Kosten | 2.500 bis 5.000 Euro Hardware | 0 Euro |
| Laufende Kosten | Strom, Wartung | Etwa 0,006 USD pro Minute Audio |
| Skalierung | Begrenzt durch eigene Hardware | Beliebig nach oben skalierbar |
| Funktioniert offline | Ja | Nein |
| Geeignet für sensible Daten | Ja, ohne Einschränkung | Nur mit zusätzlichen Vorkehrungen |
Zum Vergleichen seitlich wischen
Wann lokal Pflicht ist
Es gibt Szenarien, in denen Spracherkennung lokal laufen muss und Cloud schlicht keine Option ist:
- Gesundheitswesen mit Patientendaten: Patientennamen, Diagnosen, Befunde gehören in keine US-Cloud, auch nicht über AVV.
- Anwaltskanzleien und Steuerberatung: Mandantengeheimnis ist absolut.
- Industrie mit Konstruktionsdaten: Wenn Wettbewerber aus dem Audio Rückschlüsse auf neue Produkte ziehen könnten.
- Personalgespräche und Betriebsrats-Sitzungen: Hier verbietet sich in der Regel jede externe Verarbeitung.
Wann Cloud OK ist
Für viele Anwendungsfälle ist die Cloud völlig in Ordnung, vorausgesetzt der Datenschutz ist sauber aufgesetzt:
- Allgemeine Meeting-Transkripte ohne sensible Inhalte.
- Marketing-Calls, Webinare, Podcasts.
- Erste Pilotprojekte zum Testen einer Idee.
In allen anderen Fällen lohnt der Blick auf eine lokale Lösung. Das ist heute deutlich einfacher als noch vor drei Jahren. Wie sich lokale KI im Mittelstand grundsätzlich umsetzen lässt, zeigt der Artikel zu lokaler KI im Mittelstand. Mehr zu den DSGVO-Grundlagen findest du im Artikel zu DSGVO-konformer KI-Nutzung. KI-Spracherkennung ist dabei einer von vielen Bausteinen, die du im Überblick zu KI im Mittelstand eingeordnet findest.
DSGVO-Kurzfassung für Audio-Daten: Audio mit Personenbezug ist personenbezogenes Datum nach Artikel 4 DSGVO. Du brauchst eine Rechtsgrundlage (meistens berechtigtes Interesse oder Einwilligung), ein Verzeichnis der Verarbeitungstätigkeiten und bei sensiblen Daten eine Datenschutz-Folgenabschätzung. Cloud-Verarbeitung in den USA verlangt zusätzlich Standardvertragsklauseln und eine Transfer Impact Assessment.
Lokale Spracherkennung startet ab 2.500 Euro, Cloud ab 0,006 Dollar pro Minute
Die Kostenfrage hängt direkt am Lokal-vs-Cloud-Entscheid. Eine grobe Orientierung:
Lokale Variante (einmalige Investition):
- Server mit Consumer-GPU (RTX 4070 oder vergleichbar): ab 2.500 Euro
- Server mit Profi-GPU für mehrere parallele Streams: 5.000 bis 12.000 Euro
- Einrichtung, Integration in Praxis/CRM/Service-Software: variiert je nach Komplexität
- Laufend: Strom (etwa 100 bis 300 Euro pro Jahr), Wartung
Cloud-Variante (laufende Kosten):
- OpenAI Whisper API: rund 0,006 Dollar pro Minute Audio (Stand September 2026, Preise können sich ändern)
- Azure Speech: gestaffelt, ähnliche Größenordnung
- Bei einem Servicebetrieb mit 100 Stunden Audio pro Monat: rund 36 Dollar Cloud-Kosten
Bei hohem Volumen kippt die Rechnung früh zugunsten der lokalen Lösung. Bei niedrigem Volumen und unkritischen Daten lohnt sich der Cloud-Einstieg zum Testen.
Anforderungs-Check vor dem Projektstart:
- Konkreten Prozess identifiziert, in dem aktuell viel getippt wird
- Geklärt, ob die zu verarbeitenden Inhalte personenbezogene oder sensible Daten enthalten
- Audio-Volumen pro Monat grob abgeschätzt
- Zielsysteme (CRM, ERP, Praxis-Software) für die Transkripte festgelegt
- Datenschutzbeauftragter informiert
- Mitarbeiter im Pilot-Team benannt, der das System aktiv ausprobiert
So startest du in vier Wochen
Spracherkennung ist eines der Themen, bei denen ein Pilotprojekt schnell aussagekräftige Ergebnisse liefert. Jannis Gerlinger, Geschäftsführer der JANGER GmbH und seit 2007 in der Digitalbranche, empfiehlt eine pragmatische Vorgehensweise:
Woche 1: Anwendungsfall scharfstellen. Welcher Mitarbeiter, welche Aufgabe, welche Zielsoftware. Audio-Beispiele aus realen Aufgaben sammeln (10 bis 20 kurze Aufnahmen).
Woche 2: Modell-Auswahl. Whisper Medium oder Large, eventuell Vergleich mit einer Cloud-API auf den gleichen Audio-Beispielen. Klares Kriterium: Wort-Fehlerrate auf den eigenen Beispielen, nicht auf Benchmark-Datensätzen.
Woche 3: Integration. Das transkribierte Ergebnis muss strukturiert in die Zielsoftware. Hier zahlt sich ein simpler Workflow aus: Aufnahme, Transkription, KI-Strukturierung, Vorschau, Freigabe durch den Mitarbeiter.
Woche 4: Pilot im echten Betrieb mit einem Mitarbeiter. Daily Standup mit dem Pilotnutzer, sofort nachjustieren. Nach einer Woche Pilot weißt du, ob das System hält, was es verspricht.
Was du in diesem Pilot-Zeitraum nicht brauchst: Lastenheft, externe Berater-Workshops oder ein internes Steering-Komitee. Was du brauchst: einen motivierten Mitarbeiter, der das System aktiv ausprobiert, und jemanden, der Hardware und Software zusammensteckt.
Mikrofon, Fachvokabular und Change Management entscheiden über den Erfolg
Drei häufige Stolperfallen werden bei der Einführung von Spracherkennung regelmäßig unterschätzt:
Mikrofon-Qualität schlägt Modell-Qualität. Ein schlechtes Mikrofon kann auch das beste Modell nicht retten. Investiere lieber 200 Euro in ein gutes Lavalier- oder Headset-Mikrofon als die nächste Modellgröße zu trainieren.
Fachvokabular ohne Tuning ist Glückssache. Whisper kennt Standard-Deutsch sehr gut, aber für seltene Fachbegriffe (etwa medizinische Diagnosen, technische Bauteilbezeichnungen, eigene Produktnamen) braucht es ein Fachwörterbuch oder ein leichtes Fine-Tuning auf eigenen Audio-Beispielen.
Mitarbeiter mitnehmen. Spracherkennung verändert Arbeitsabläufe. Wer 20 Jahre lang nach Termin getippt hat, kommt mit Diktieren am Anfang nicht gut zurecht. Plane eine kurze Einführung und einen Champion im Team ein.
Fazit
KI-Spracherkennung ist 2026 in den meisten Mittelstands-Anwendungen reif. Die Technik liefert, was sie versprochen hat. Die eigentliche Frage ist nicht mehr, ob das funktioniert, sondern wo in deinem Unternehmen heute Zeit ins Tippen fließt, die ins Sprechen verlagert werden kann. Für DSGVO-sensible Bereiche ist die lokale Variante mit Whisper inzwischen so unkompliziert, dass kein Grund mehr besteht, sensible Audiodaten an Cloud-Anbieter zu schicken.
Wenn du wissen willst, wo bei dir der größte Hebel liegt: In einer kostenlosen 30-Minuten-Demo schauen wir gemeinsam auf einen konkreten Prozess in deinem Unternehmen und prüfen, ob Spracherkennung das richtige Werkzeug ist. Termin direkt buchen.
In 15 Minuten findest du heraus, wo KI in deinem Betrieb den größten Hebel hat. Kostenlos, unverbindlich.
Analysegespräch buchen
Jannis Gerlinger berät kleine und mittlere Unternehmen bei der Einführung von Künstlicher Intelligenz und setzt die Lösungen selbst um: KI-Assistenten, Automationen und individuelle Web-Apps. Als Geschäftsführer der JANGER GmbH arbeitet er seit 2007 an digitalen Systemen für Handwerk, Handel und Industrie, von Onlineshops bis zu internen Werkzeugen. Seine vom TÜV Rheinland geprüfte Qualifikation in Verkaufspsychologie verbindet technisches Know-how mit einem tiefen Verständnis für Geschäftsprozesse.